Vibe Coding 做产品:让 AI 当测试工程师,自动跑全流程测试
以 CATALK 为例,讲测试工程师的四件事、测试用例和自动化脚本,以及让 AI 列用例清单、造假数据、写进入口文件的三步做法;附一段可直接复制的提示词。
页面一多,手动点测既累又点不全。让 AI 当测试工程师:先读需求列测试用例清单,经你确认后写成能自动运行的测试;拿不到的数据让它自己造;把跑测试写进入口文件,每次改完代码自动跑一遍、报告结果;模拟器测不到的部分,由你上手验证。
页面一多,手动点测就点不过来了
很多新手刚开始 Vibe Coding 时,产品只有一两个页面,改完自己点一下,没问题就行了。
可是越做越复杂:页面越来越多,每个页面又有好几种状态。每改一次,自己都得从头到尾点一遍,点到后面人都麻了,而且还不一定点得全。
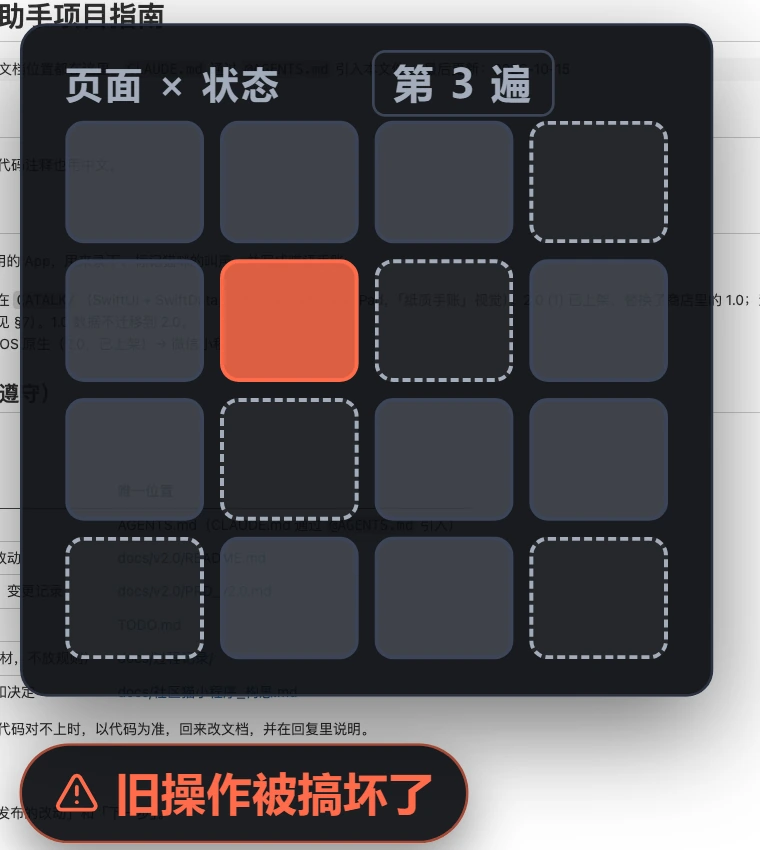
结果就是:这次加了一个新功能,把之前一个好好的旧操作搞坏了,自己压根没发现;等到上线一用,bug 一个一个往外冒。
这件事在传统产研团队里有专人负责,就是测试工程师。而在 Vibe Coding 的时候,这个工作可以交给 AI。
这一篇以作者自己做的 App CATALK(记录猫咪叫声的软件,已上架 App Store)为例,讲怎么让 AI 当你项目的测试工程师,做自动化的产品全流程测试。
测试工程师平时在干什么
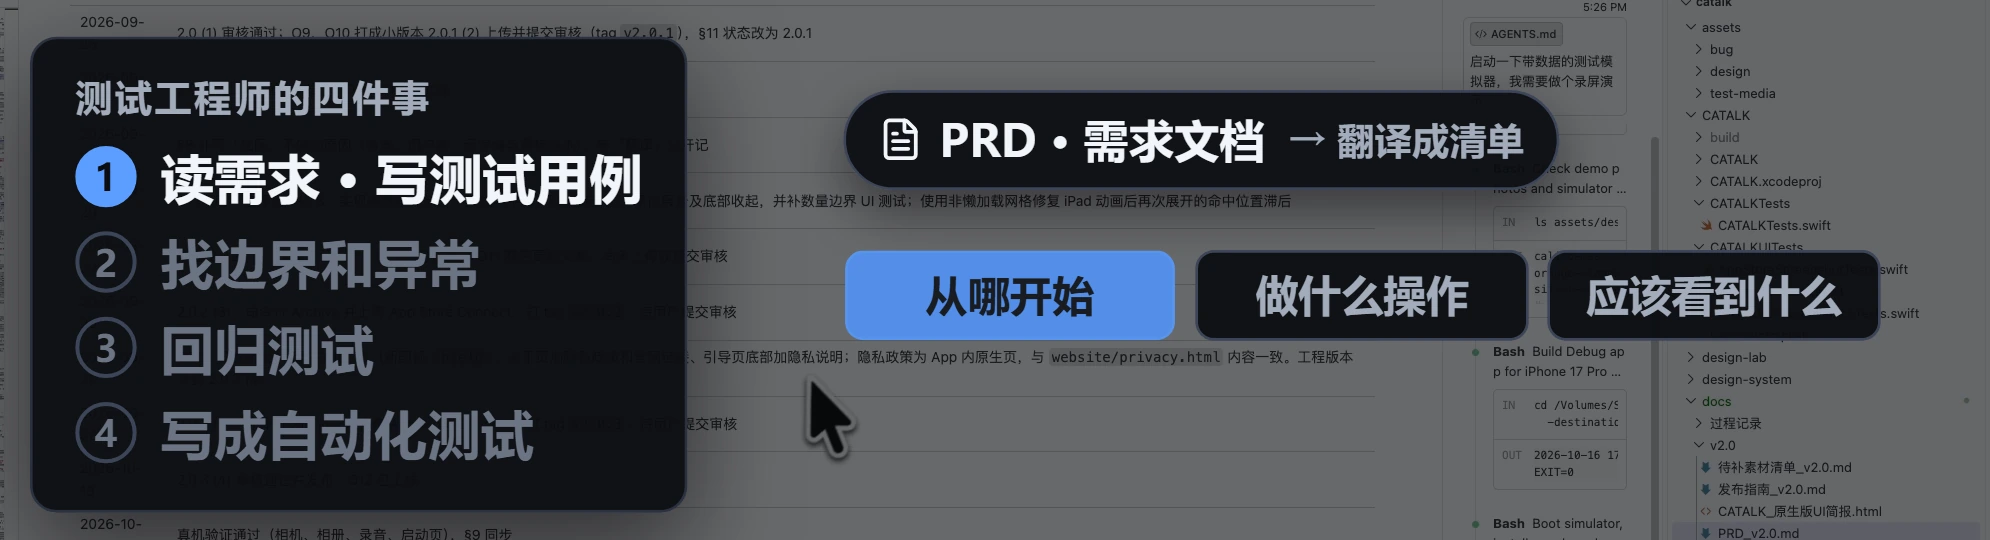
在传统产研团队里,测试工程师主要做四件事:
1. 读需求,写测试用例。 产品经理写好需求文档 PRD,测试把它翻译成一条一条能检查的清单:从哪开始、做什么操作、应该看到什么结果。
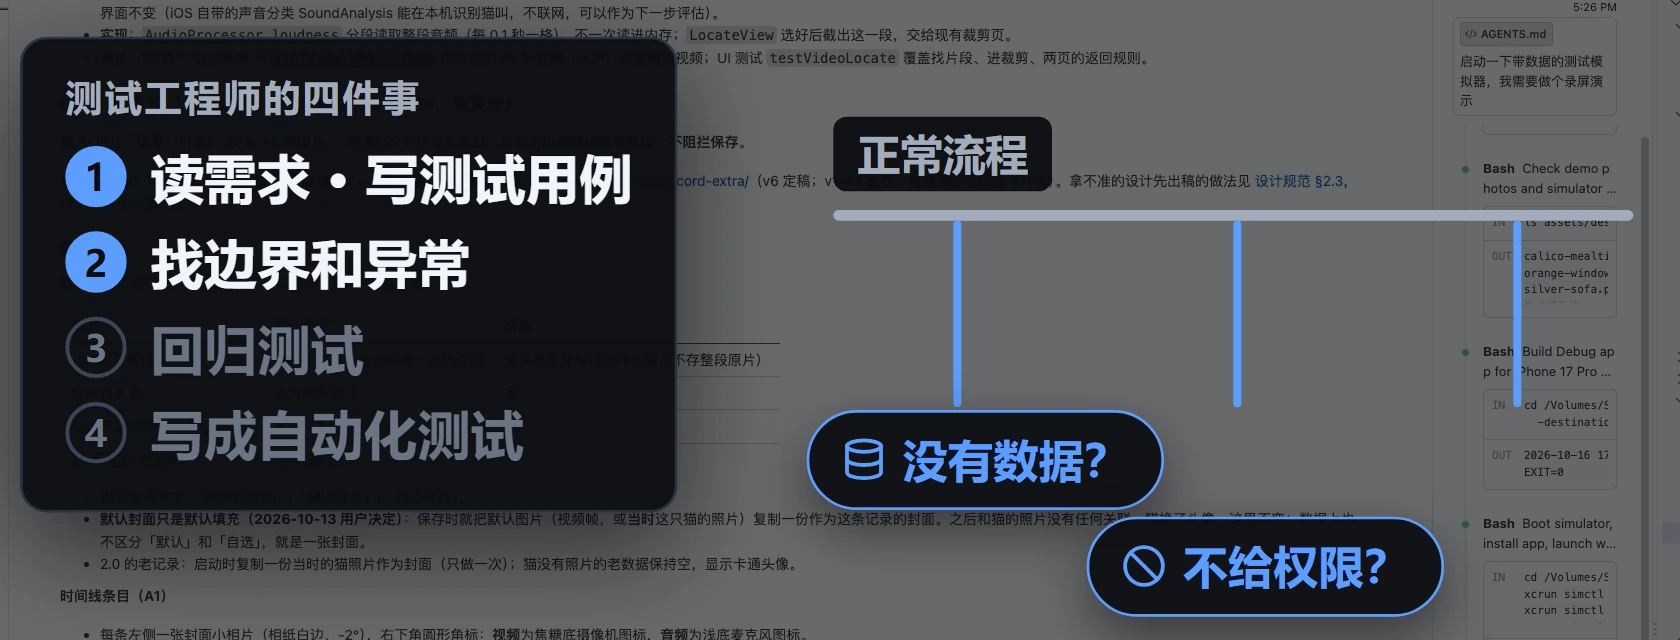
2. 专门找边界和异常。 产品和开发想的大多是正常流程,测试专门想那些不正常的:没有数据怎么办?不给权限怎么办?用户点了一半返回了怎么办?
3. 回归测试。 每次发布新版本,不光要测新功能,还要把旧功能全部跑一遍,确保没有被新的改动弄坏。
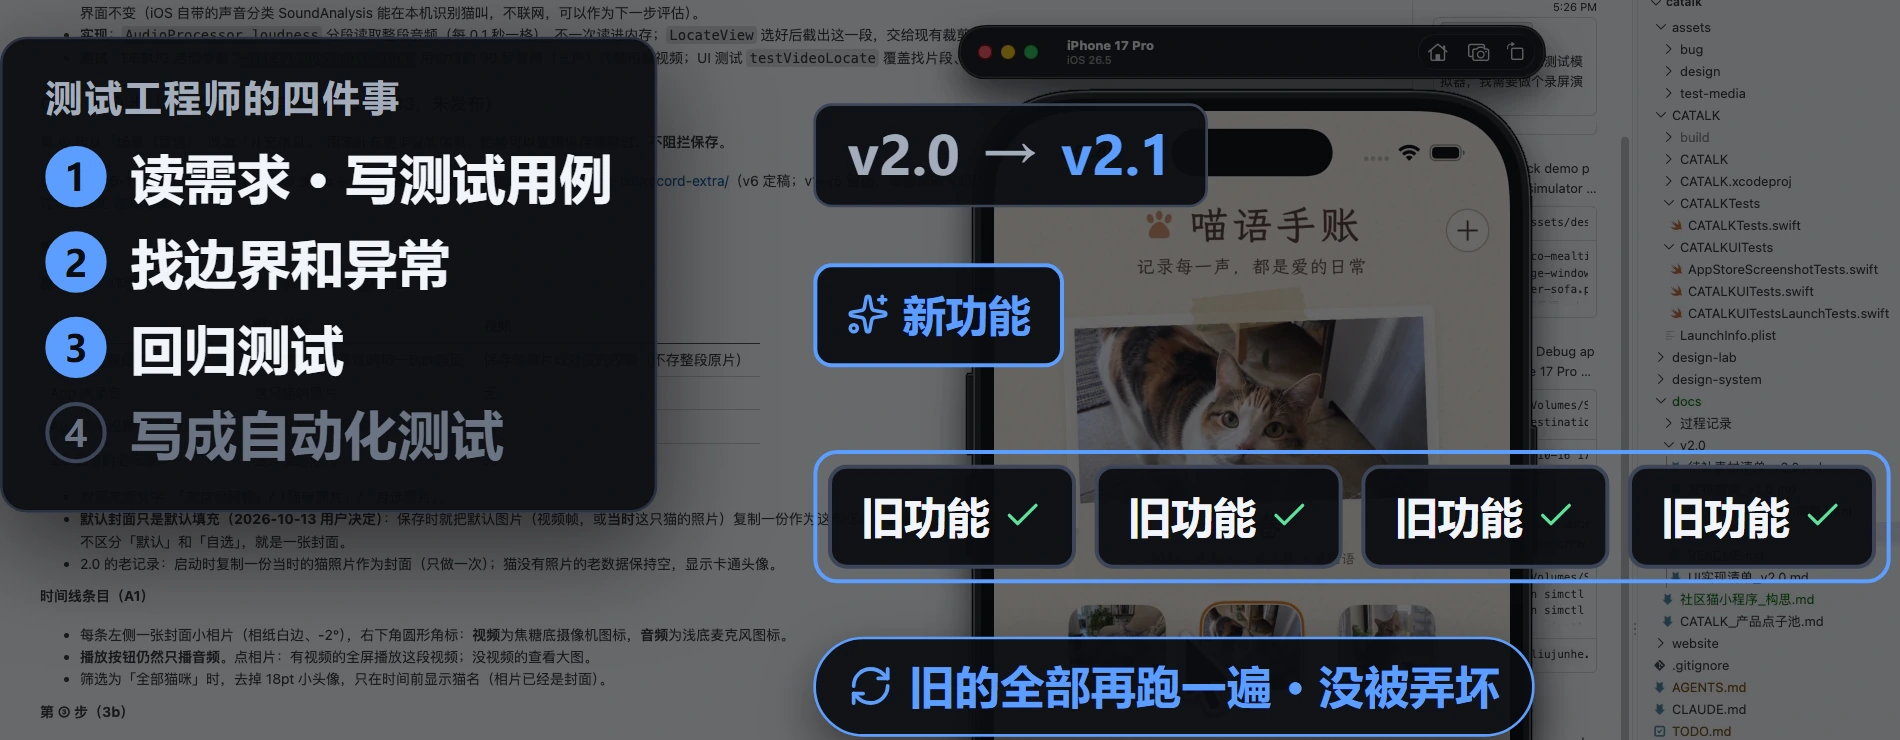
4. 写成自动化测试。 同一套流程每次发版都要跑,那就写成程序,让机器自己去点,人只看结果。
你一个人 Vibe Coding 做产品,这些事情也必须有人去做,但你不用自己当测试工程师,可以让 AI 来当。
测试交出来的两样东西:用例和脚本
很多人做完一个功能是这么测的:自己打开点一遍,主流程没问题,就算过了。
但测试工程师交出来的其实是两样东西。
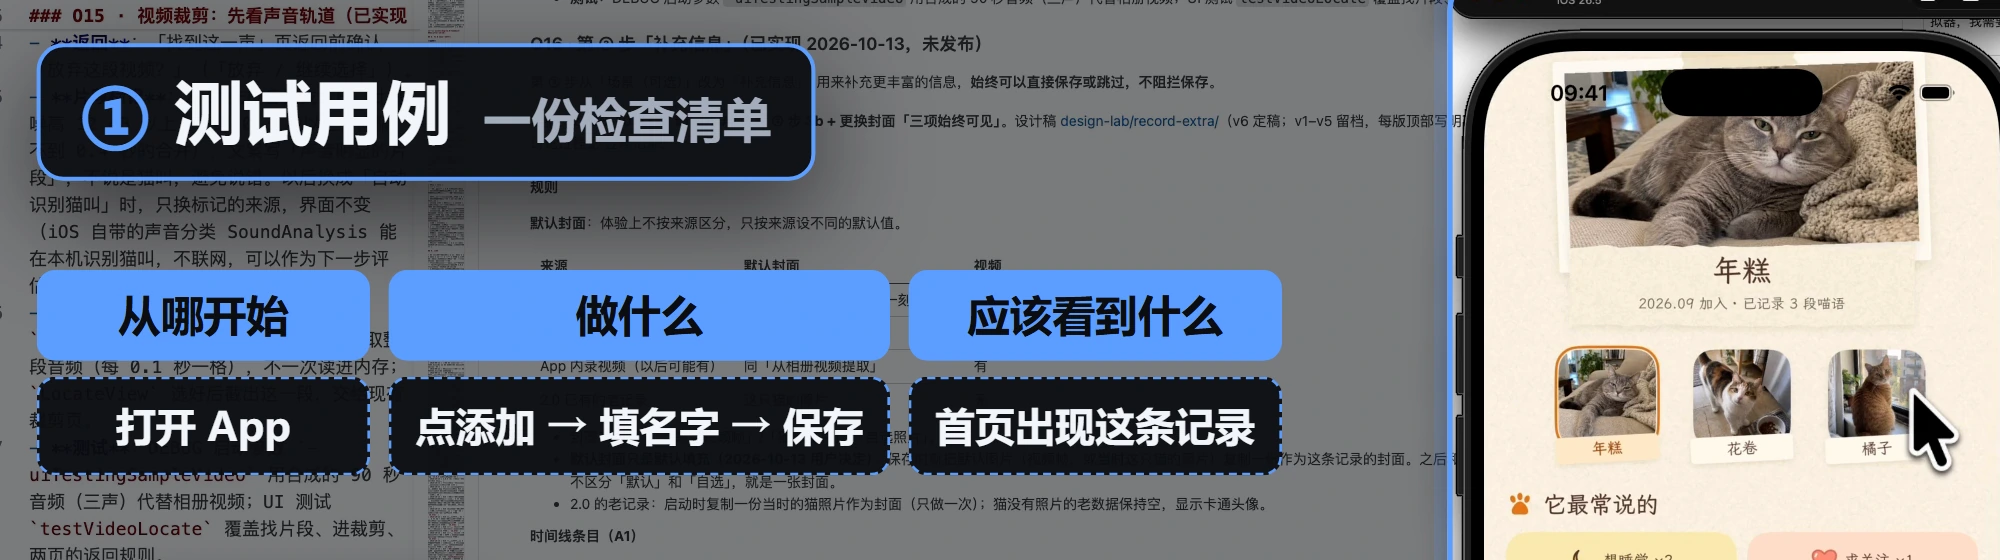
① 测试用例:一份检查清单
每一条写清楚三件事:从哪开始、做什么、应该看到什么。比如:打开 App,点「添加」,填好名字点保存,首页应该出现这条记录。这就是一条用例。
② 自动化测试脚本:把清单写成程序
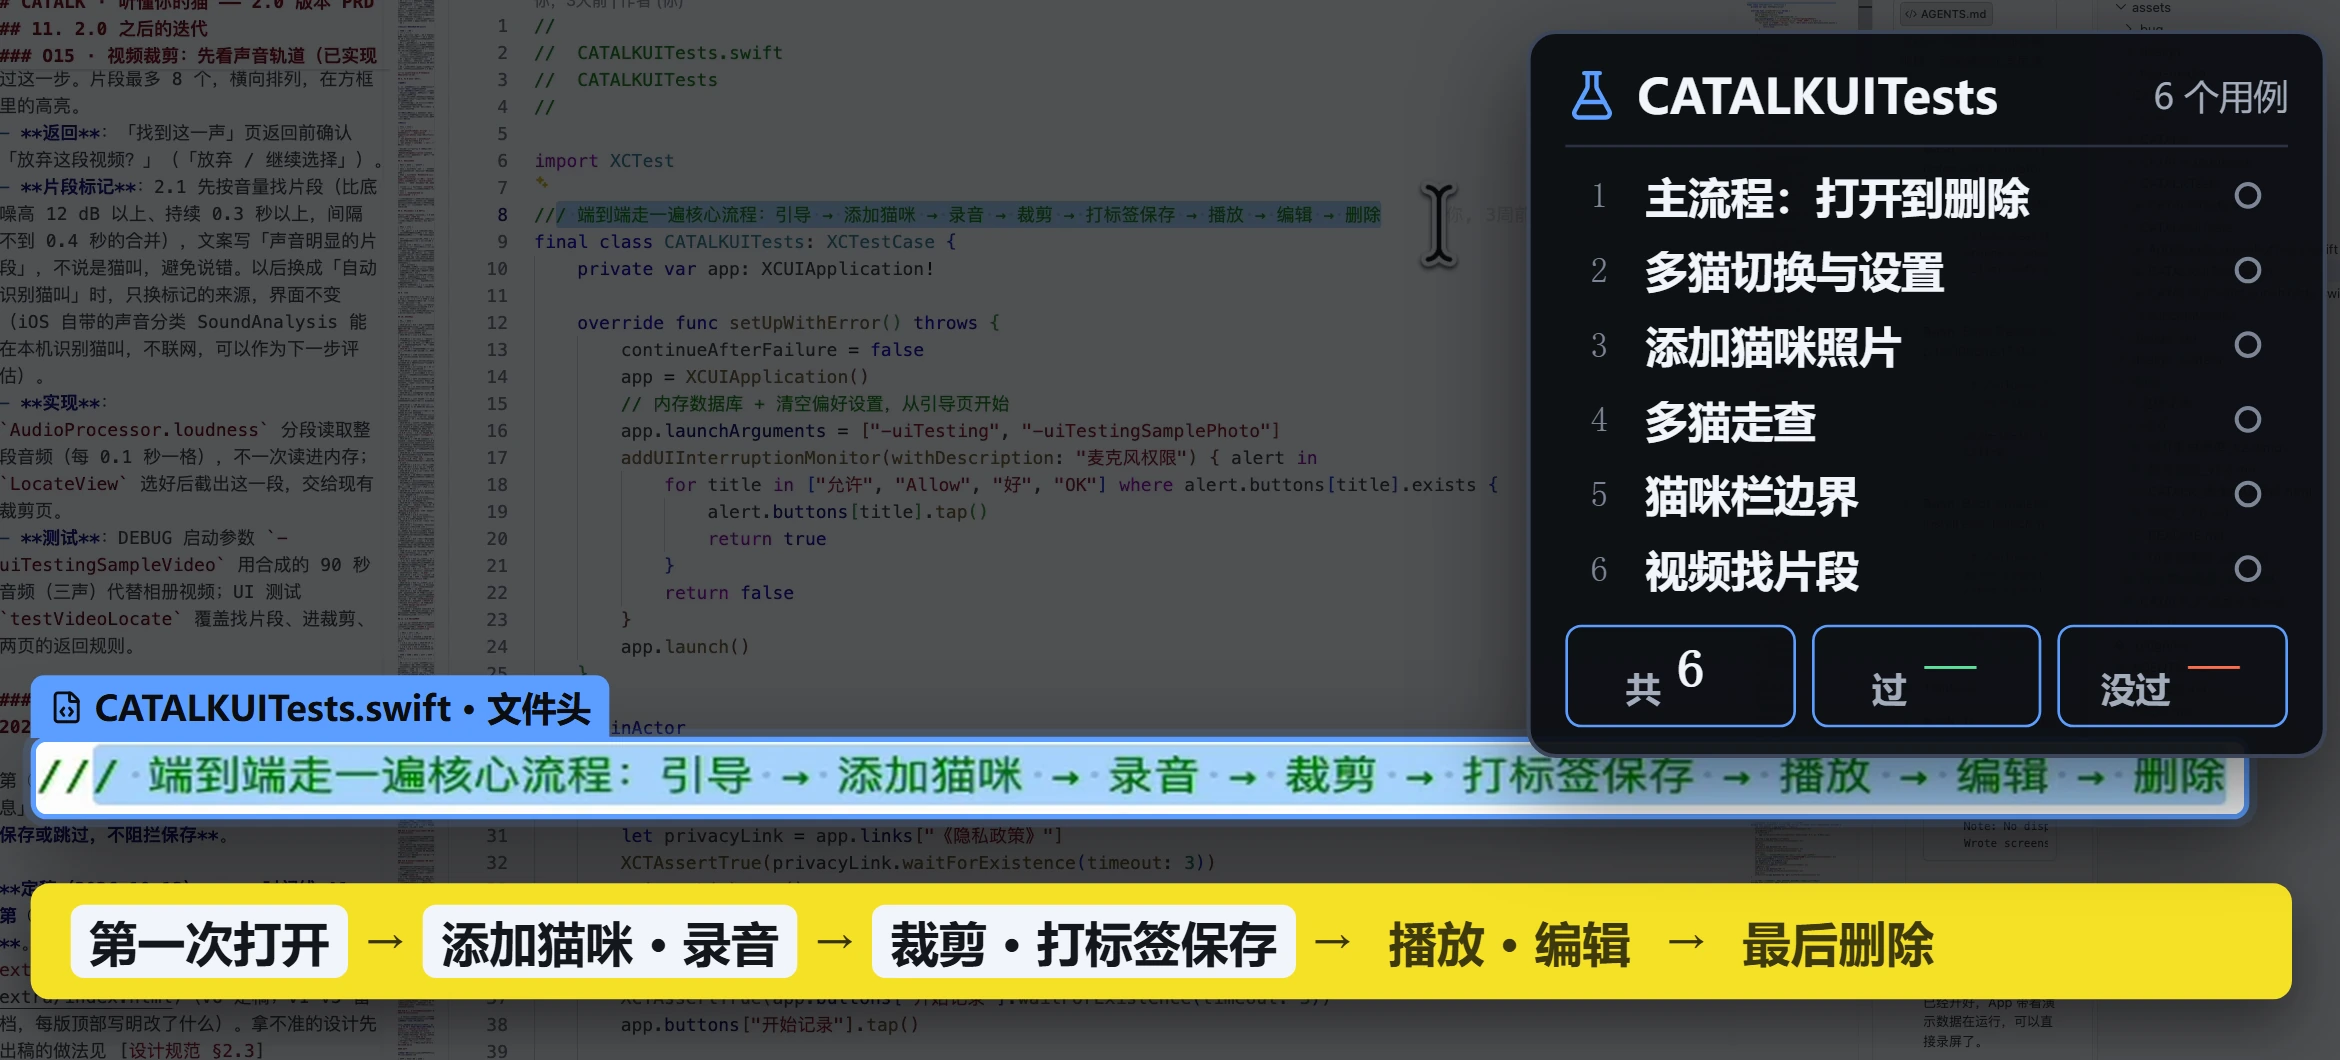
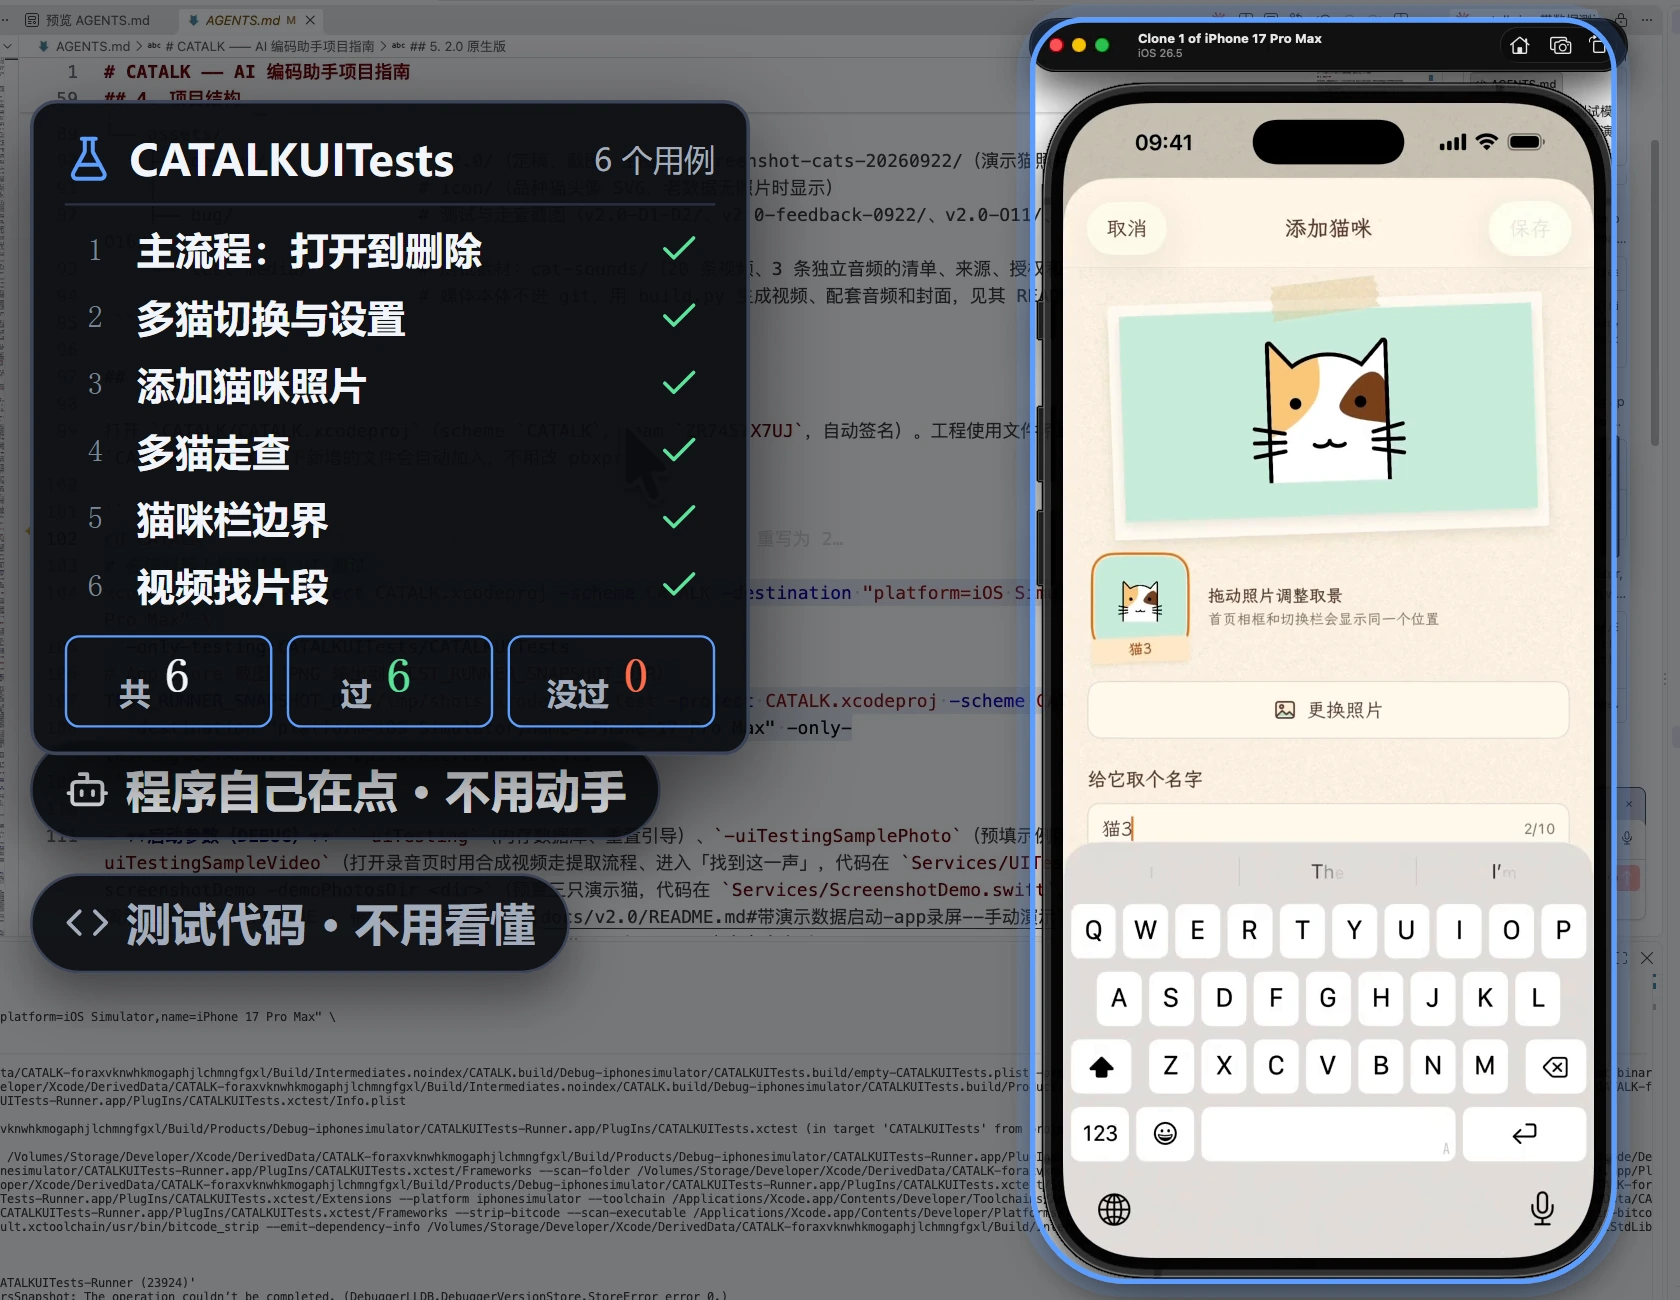
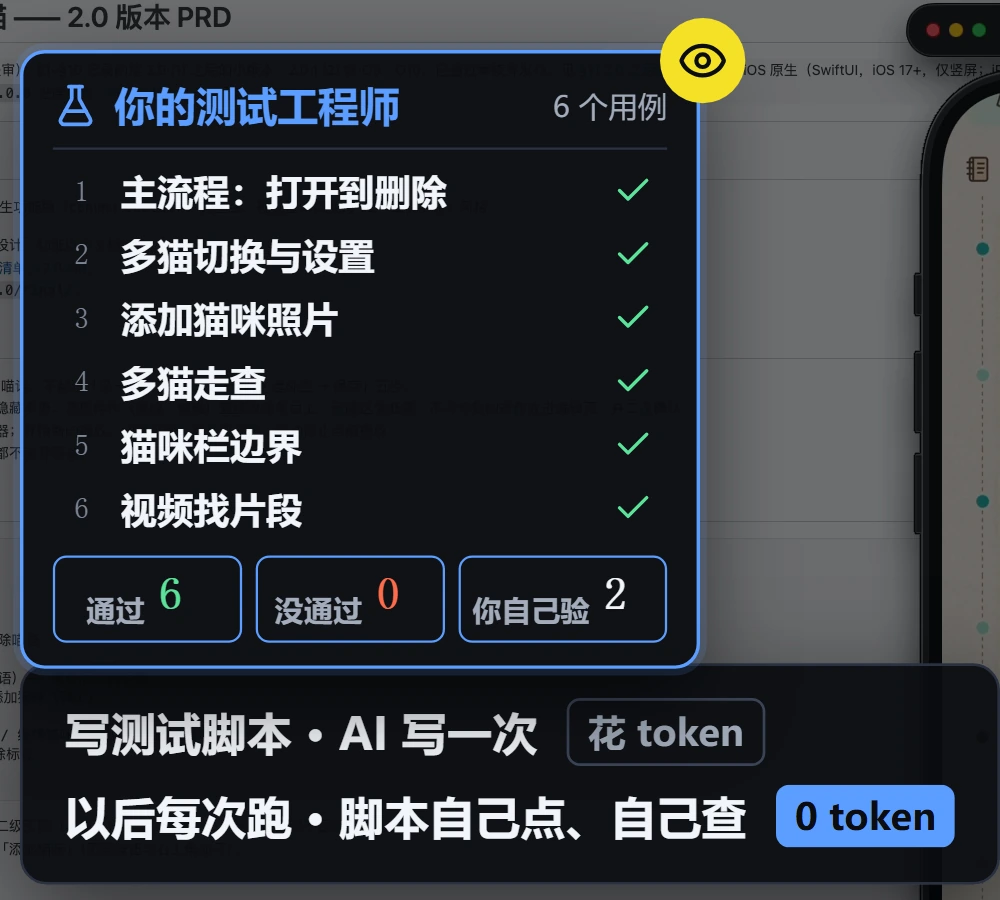
让 AI 把这份清单写成程序。程序会模拟一个用户一步一步去点,每点一步自动检查结果对不对,最后告诉你一共做了多少条、过了几条、哪条没过。
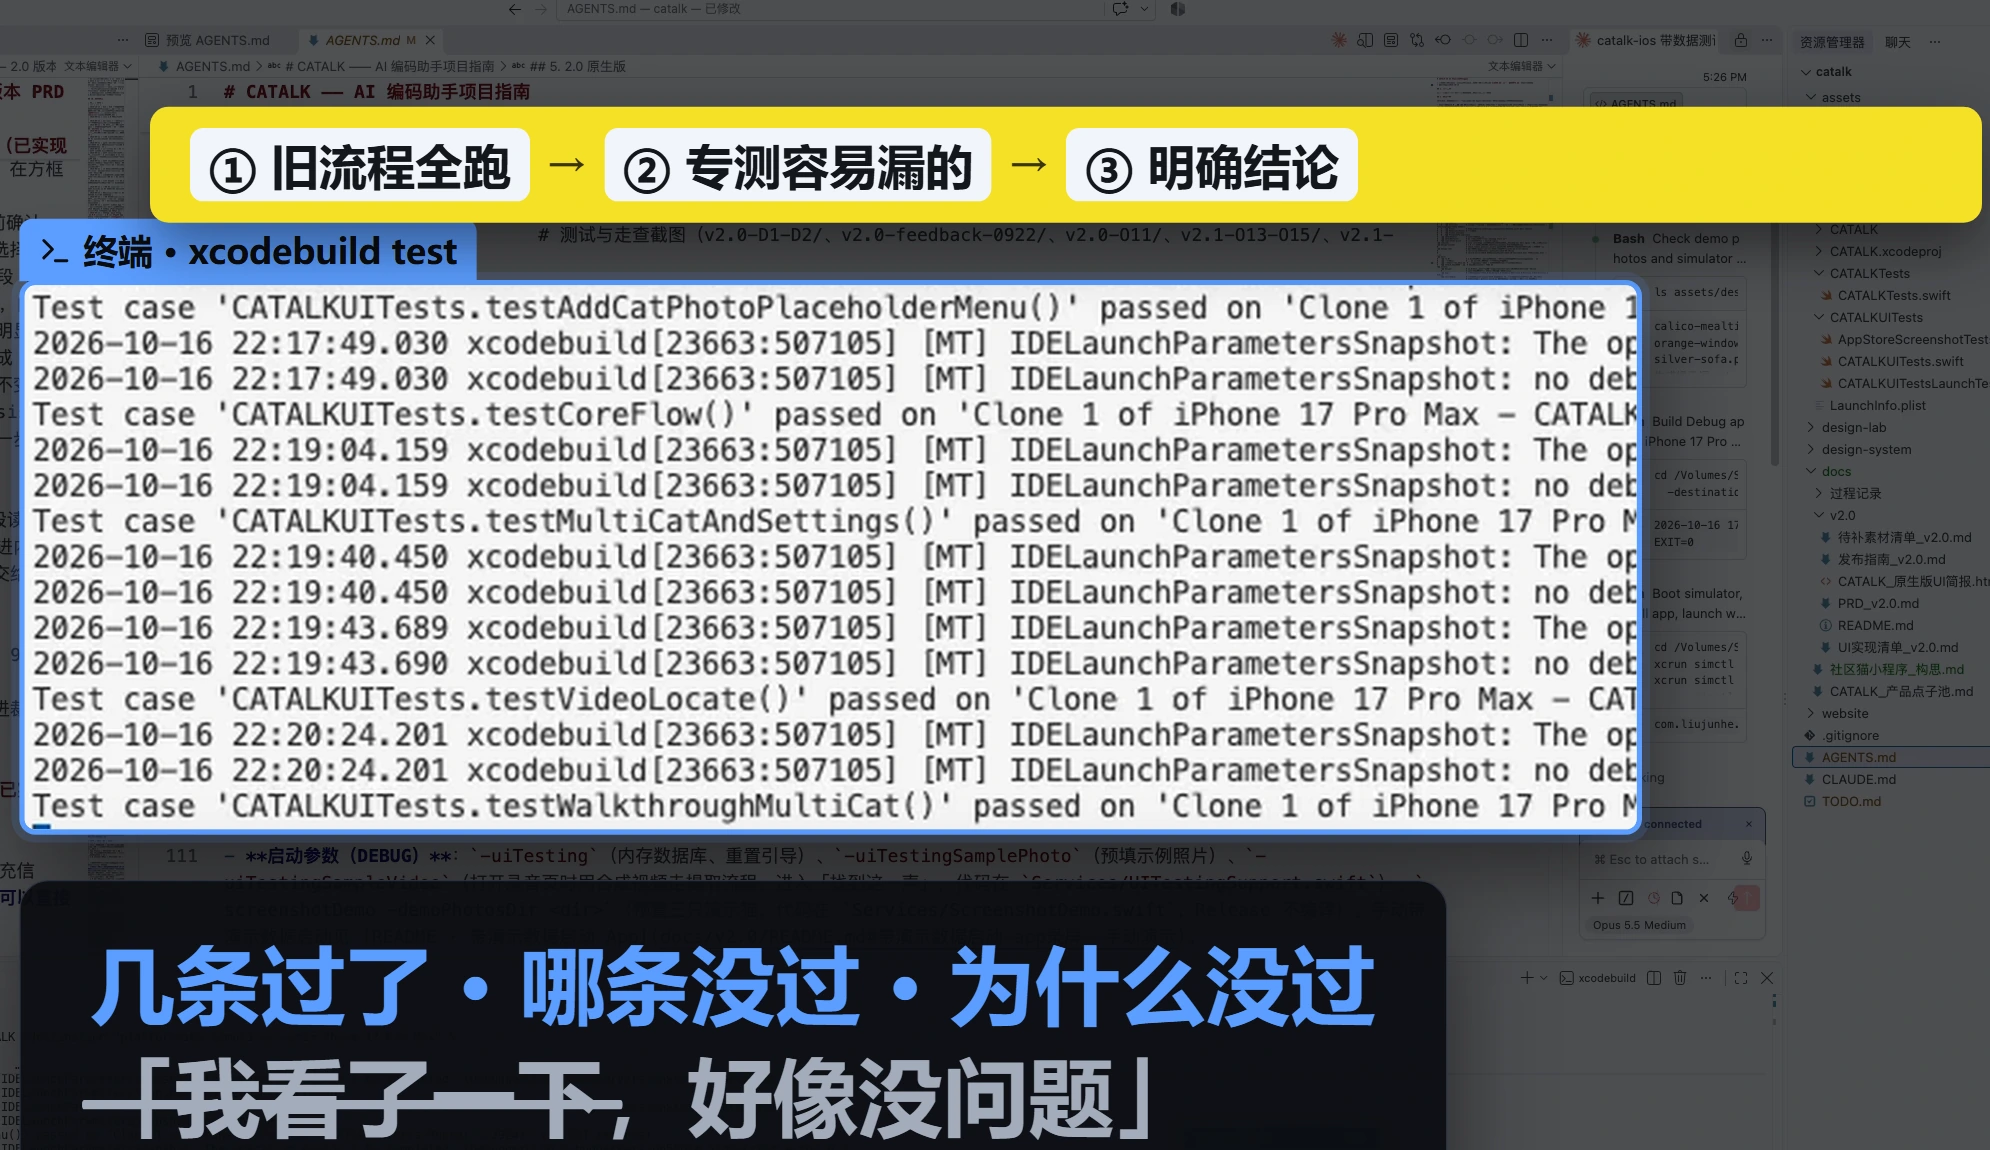
CATALK 现在一共有 6 个这样的用例,整条核心流程是:第一次打开 → 添加猫咪、录音 → 裁剪、打标签、保存 → 播放、编辑 → 最后删除。
只要一跑起来,就能看到模拟器里 App 自己在点,完全不用动手。测试代码你不用看懂,只看结果就行。
让 AI 做测试,核心就三件事
测试用例是一张完整的地图,产品的边边角角、各种情况都画在上面,每次都按着地图从头点到尾。让 AI 做测试,核心是三件事:
① 每次改完,旧流程全部跑一遍。 新改动不要把旧操作弄坏,弄坏了当场就能发现。
② 专门覆盖人容易漏的地方。 点了返回、点了取消、放弃保存、一条数据都没有、数据特别多。这些情况你自己点的时候,基本想不起来。
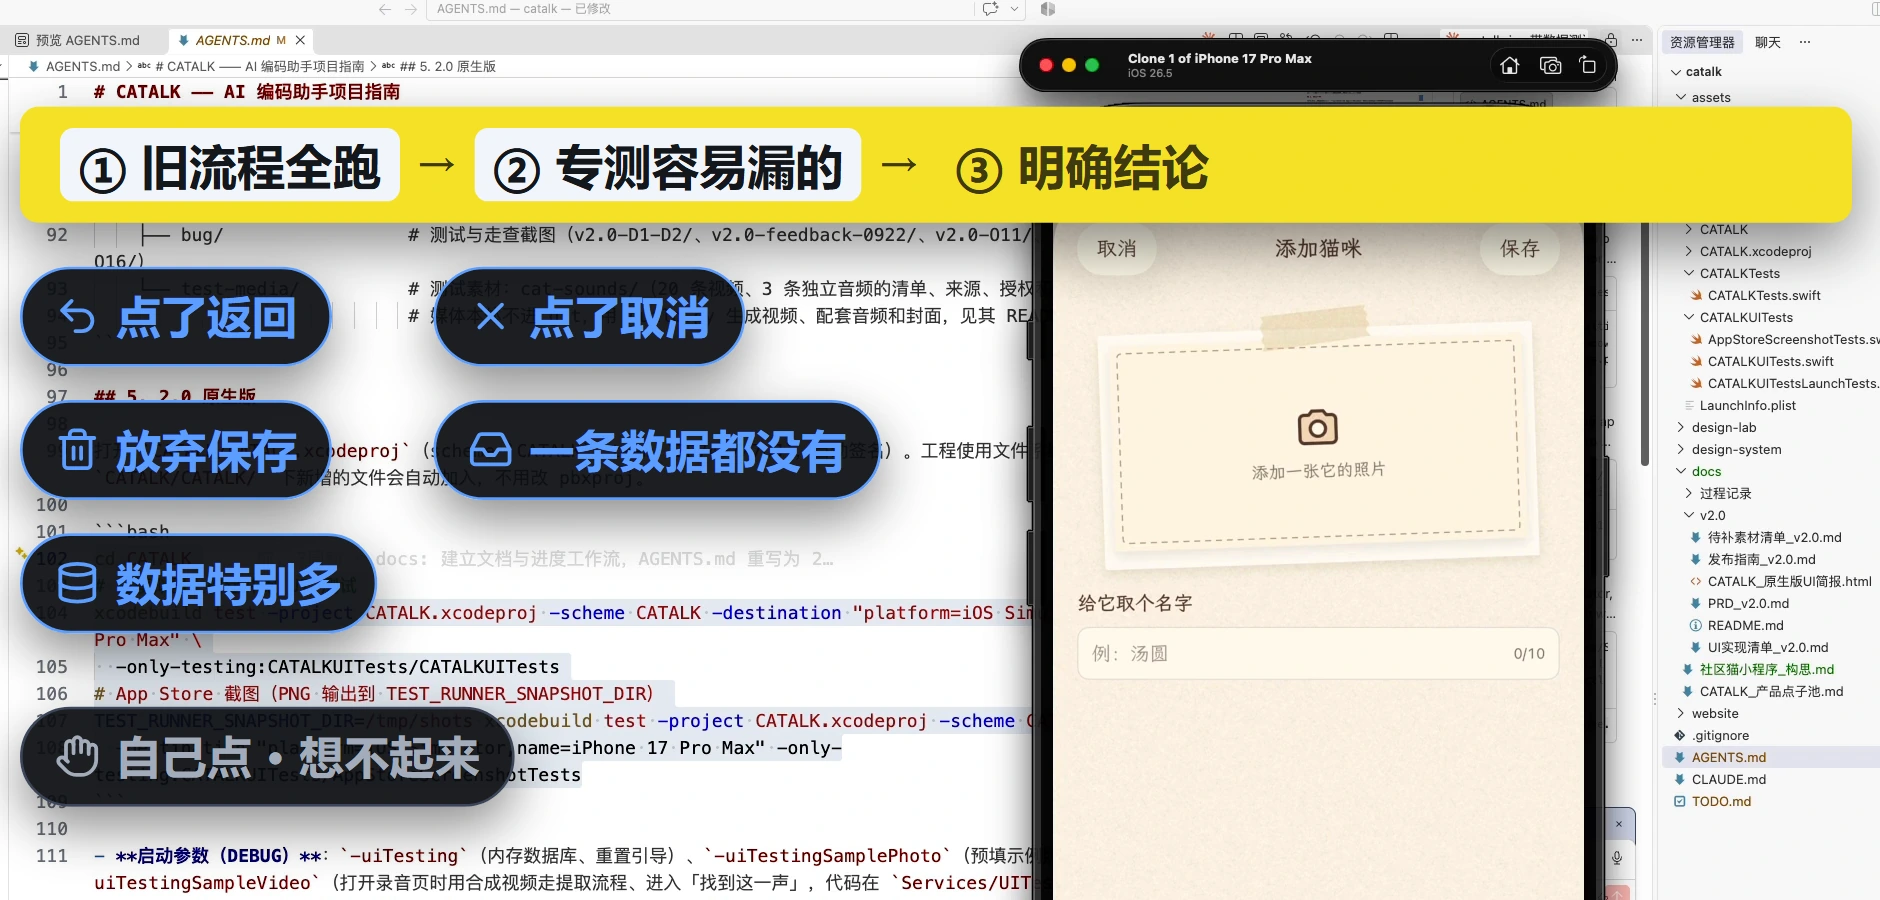
③ 测完给一个明确的结论。 哪几条过了,哪几条没过,为什么没过,而不是「我看了一下,好像没问题」这种话。
一个例子:新页面挪走了确认框
CATALK 前段时间加了一个新功能:导入一段视频后,先进一个新页面「找到这一声」,找到猫叫的那一段,再去裁剪。
以前从裁剪页返回会弹一个确认框,问你要不要放弃;加了新页面之后,视频来源的这个确认框要挪到新页面上去。
这种改动最容易出问题:新页面可能没弹出来,或者裁剪页在不该弹的地方又弹了。测试会同时检查这两处:
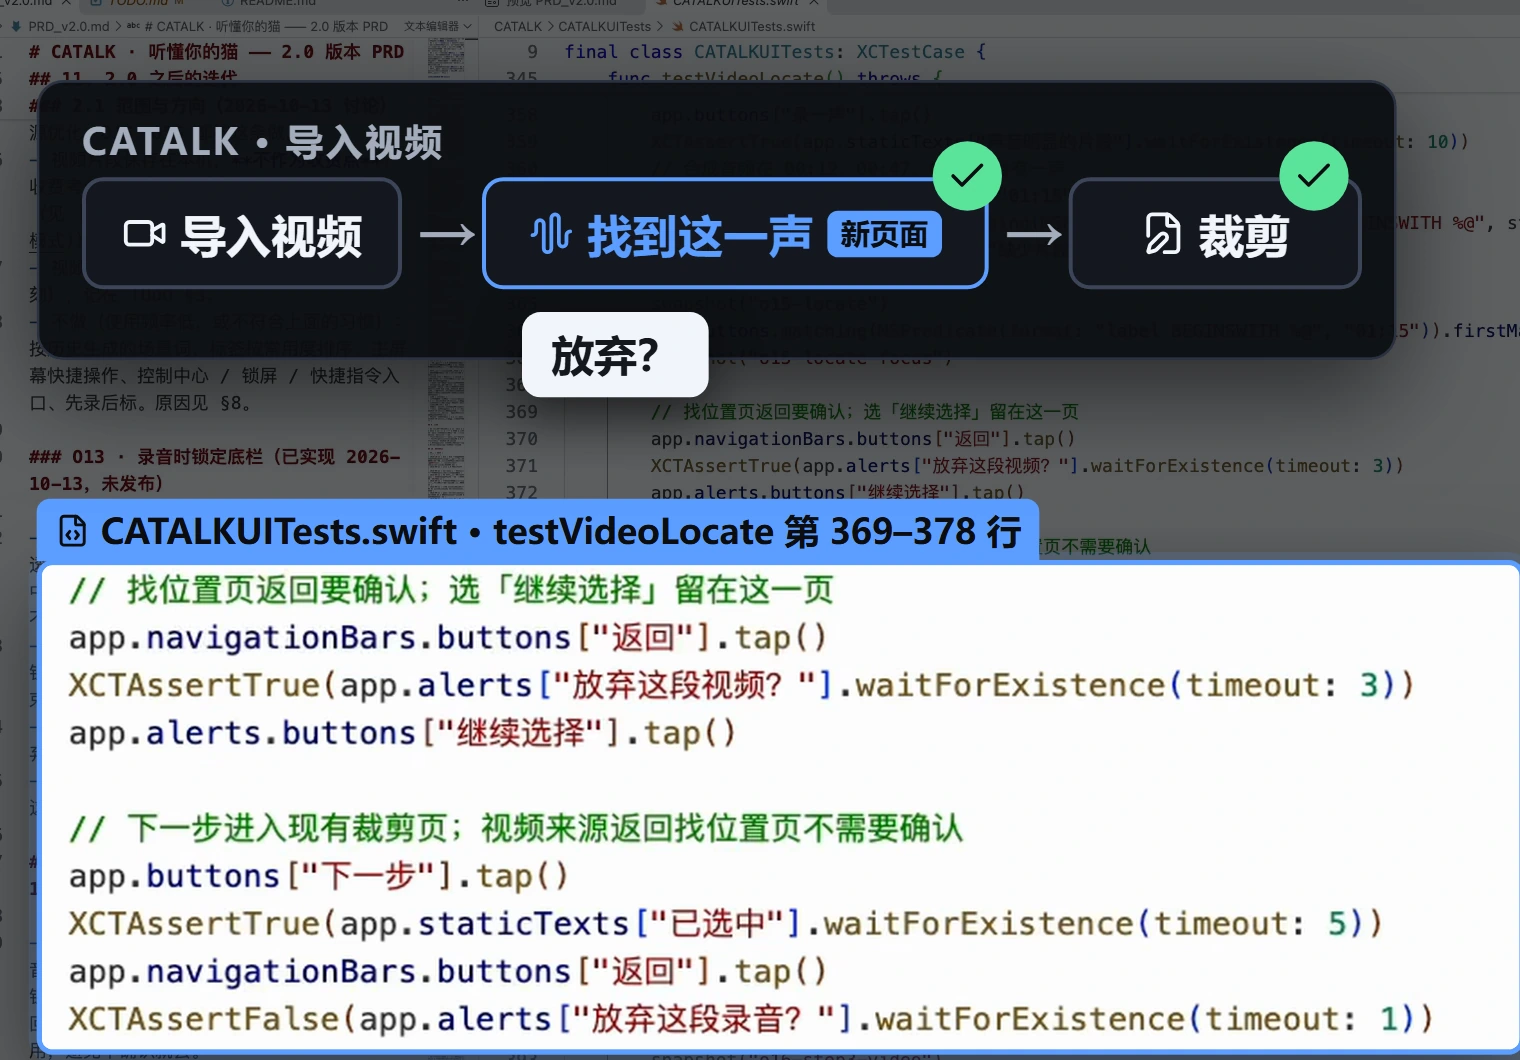
新功能做完,旧规则有没有被碰坏,跑一遍就知道了。
让 AI 当测试工程师:三步走
每个人用的平台不一样,有人做网页,有人做 App,用的 AI 工具也不一样,所以具体用什么测试工具、代码怎么写,没办法一一对应。这里讲的是方法:每一步只说让 AI 做什么,怎么实现交给你自己的 AI,按你的项目去完成。
第一步:先列测试用例清单
先让 AI 读你的需求文档,列测试用例清单。注意是先列清单,你看过了再让它去写。清单里至少要有:
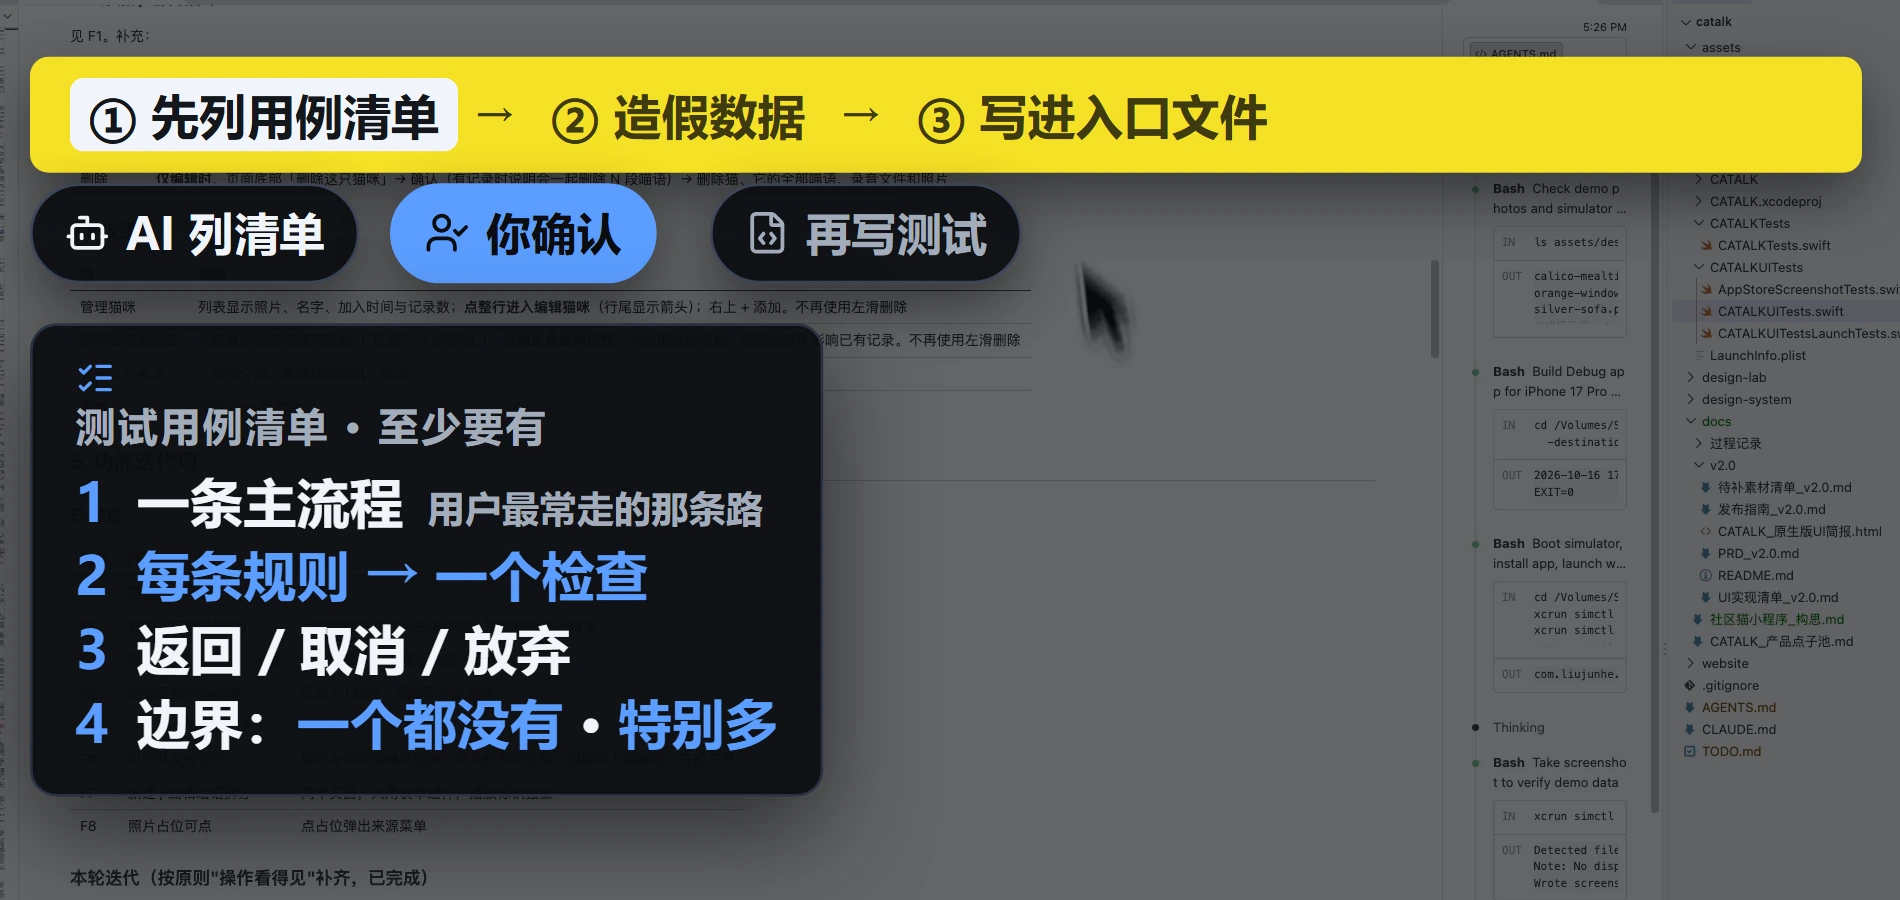
- 一条从头到尾的主流程,也就是用户最常走的那条路;
- 需求里的每一条规则,都有一个对应的检查;
- 返回、取消、放弃这几个操作都要测;
- 边界情况:一个都没有、特别多。
第二步:制造假数据
有些东西在测试里拿不到,比如相册、相机、网络。这时让 AI 自己制造一份假数据。
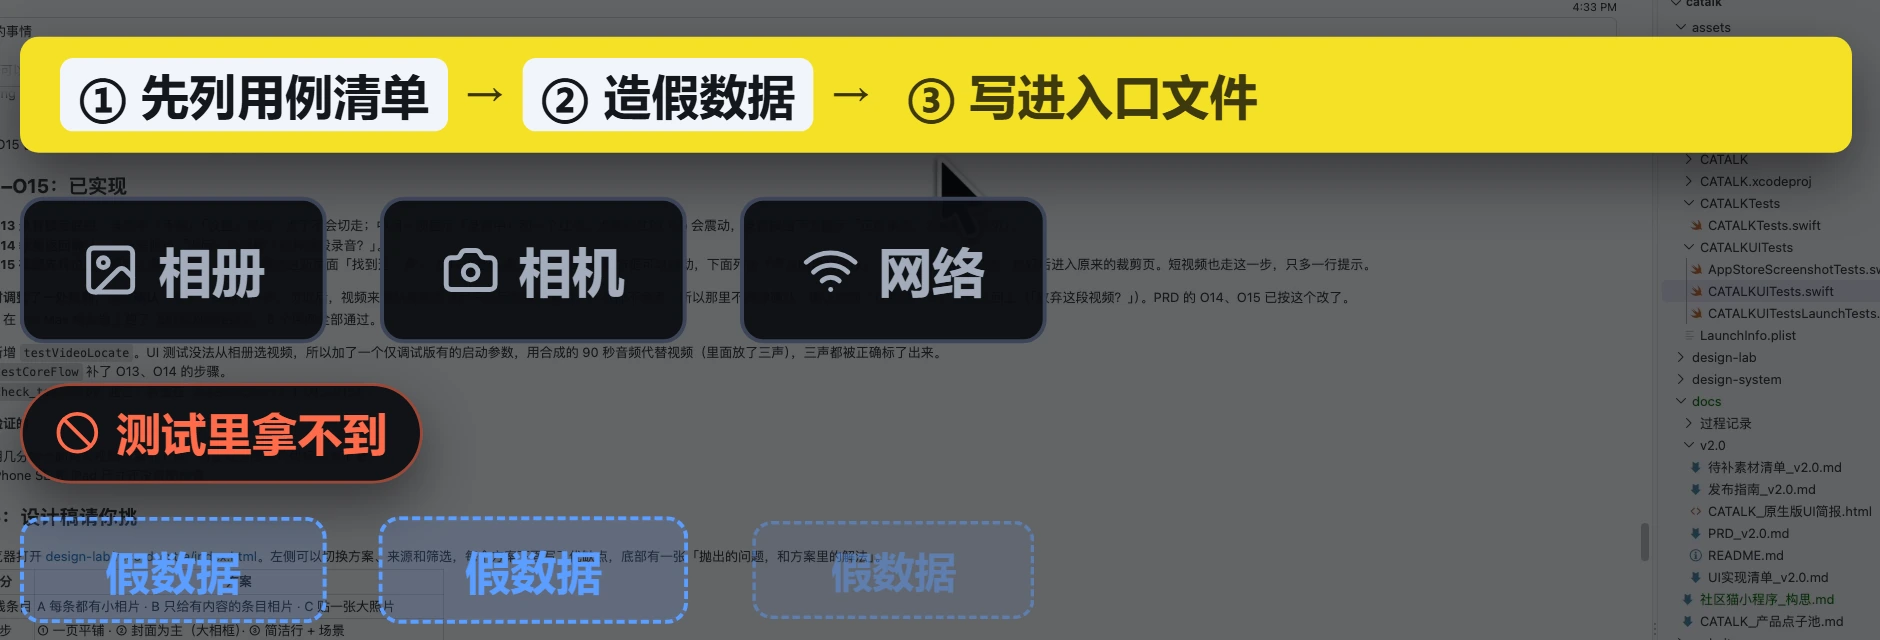
比如 CATALK 有个功能:从相册里选一段视频,自动找出里面的猫叫。可测试时,程序没办法去相册里选视频。
AI 的做法是让 App 合成一段 90 秒的视频,在第 12 秒、47 秒、75 秒各放一声猫叫。测试时只需要检查一件事:是不是正好对到了这三个点位。
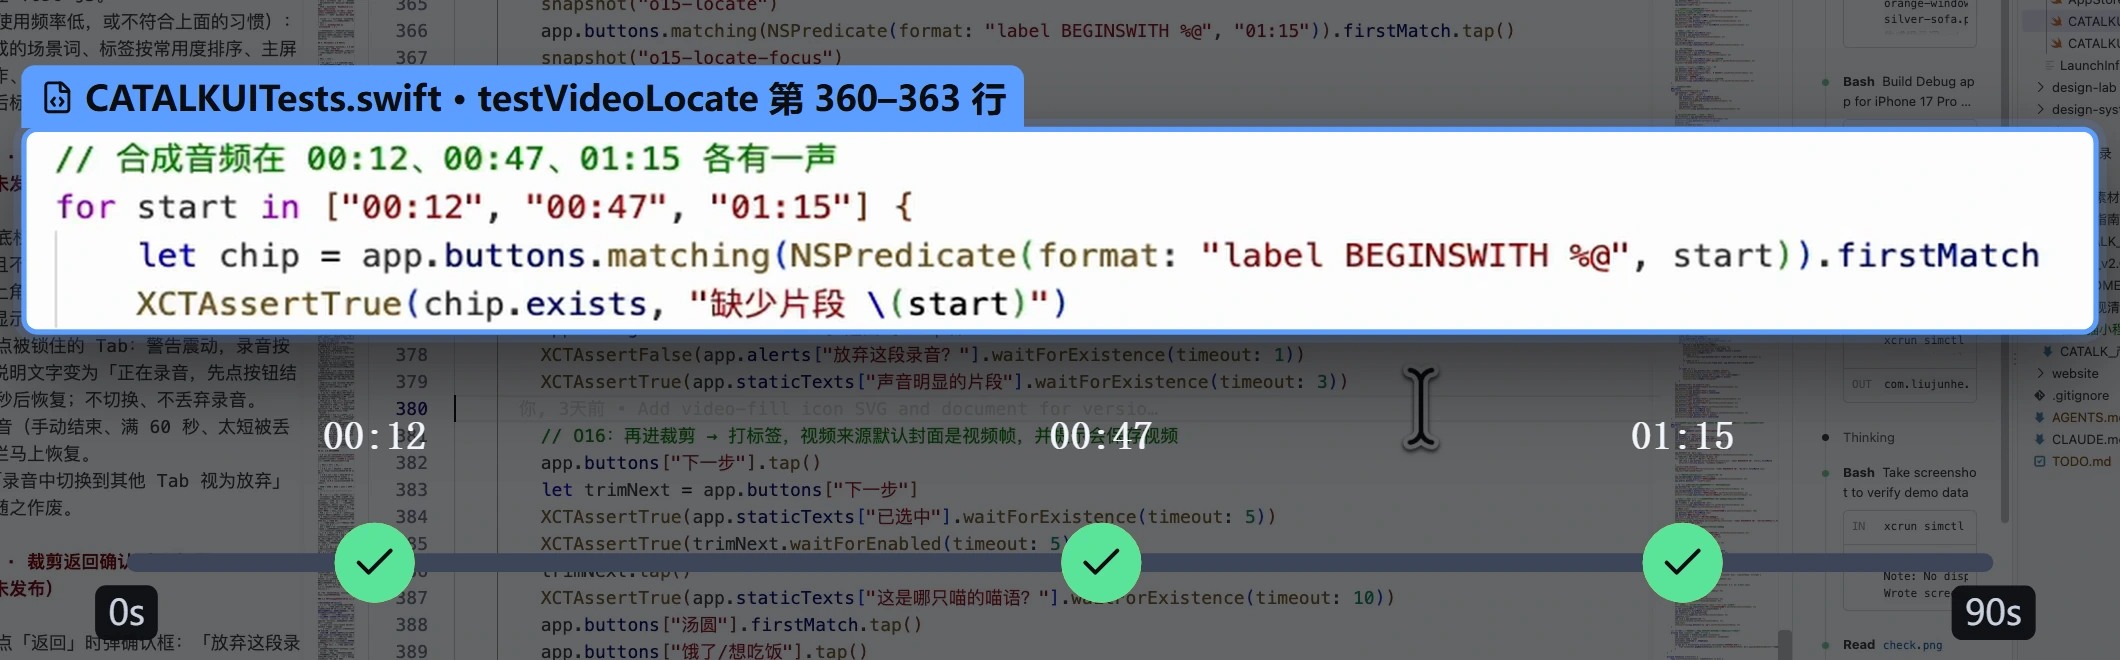
这就像一张已知答案的考卷,测试用的假数据就做好了。
第三步:写进入口文件
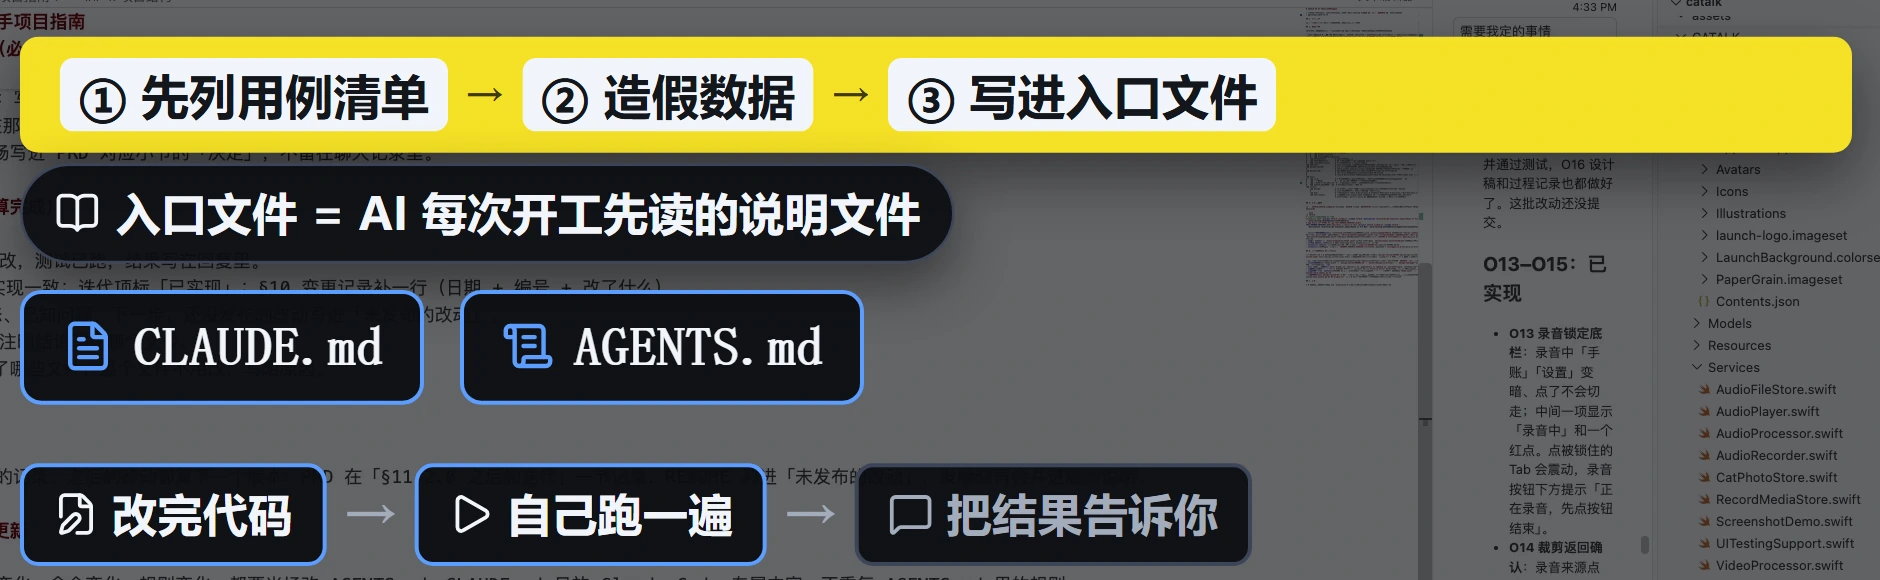
入口文件就是 AI 每次开工都会读的说明文件,比如 CLAUDE.md、AGENTS.md。测试建好后写进入口文件:每次改完代码,它都会自己跑一遍,把结果告诉你;需求改了,测试也要跟着改。
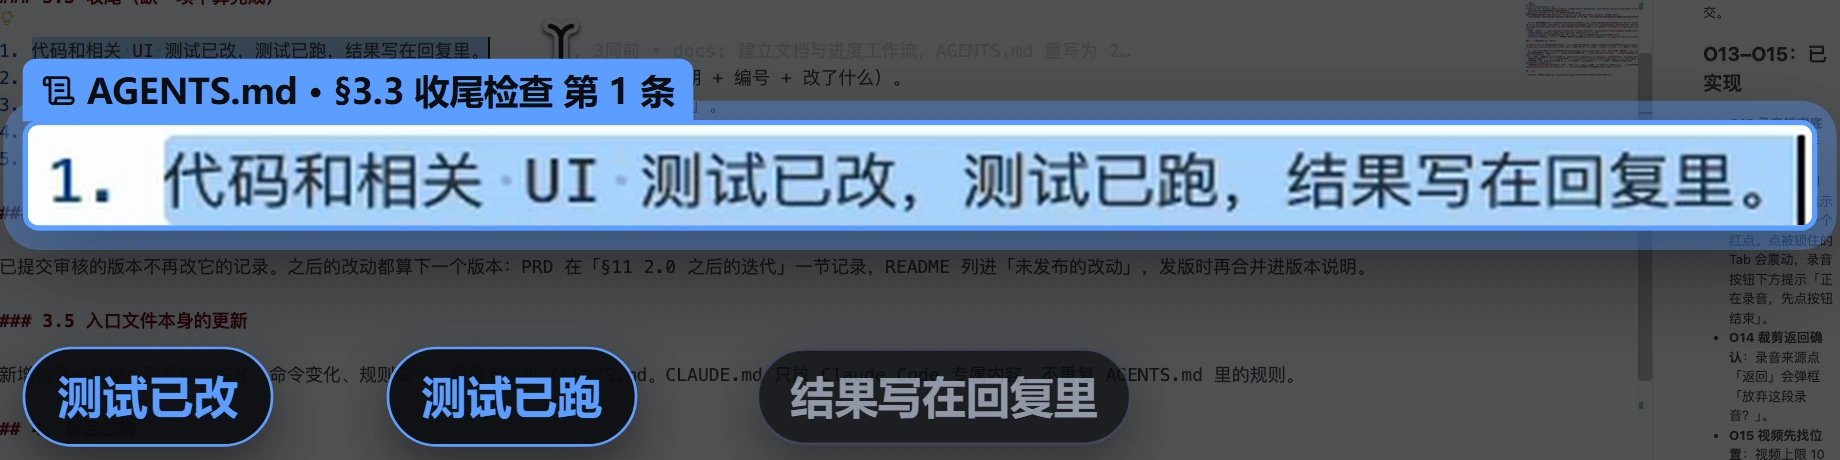
比如 CATALK 的 AGENTS.md,收尾检查的第一项就是:
测不到的,交给你上手
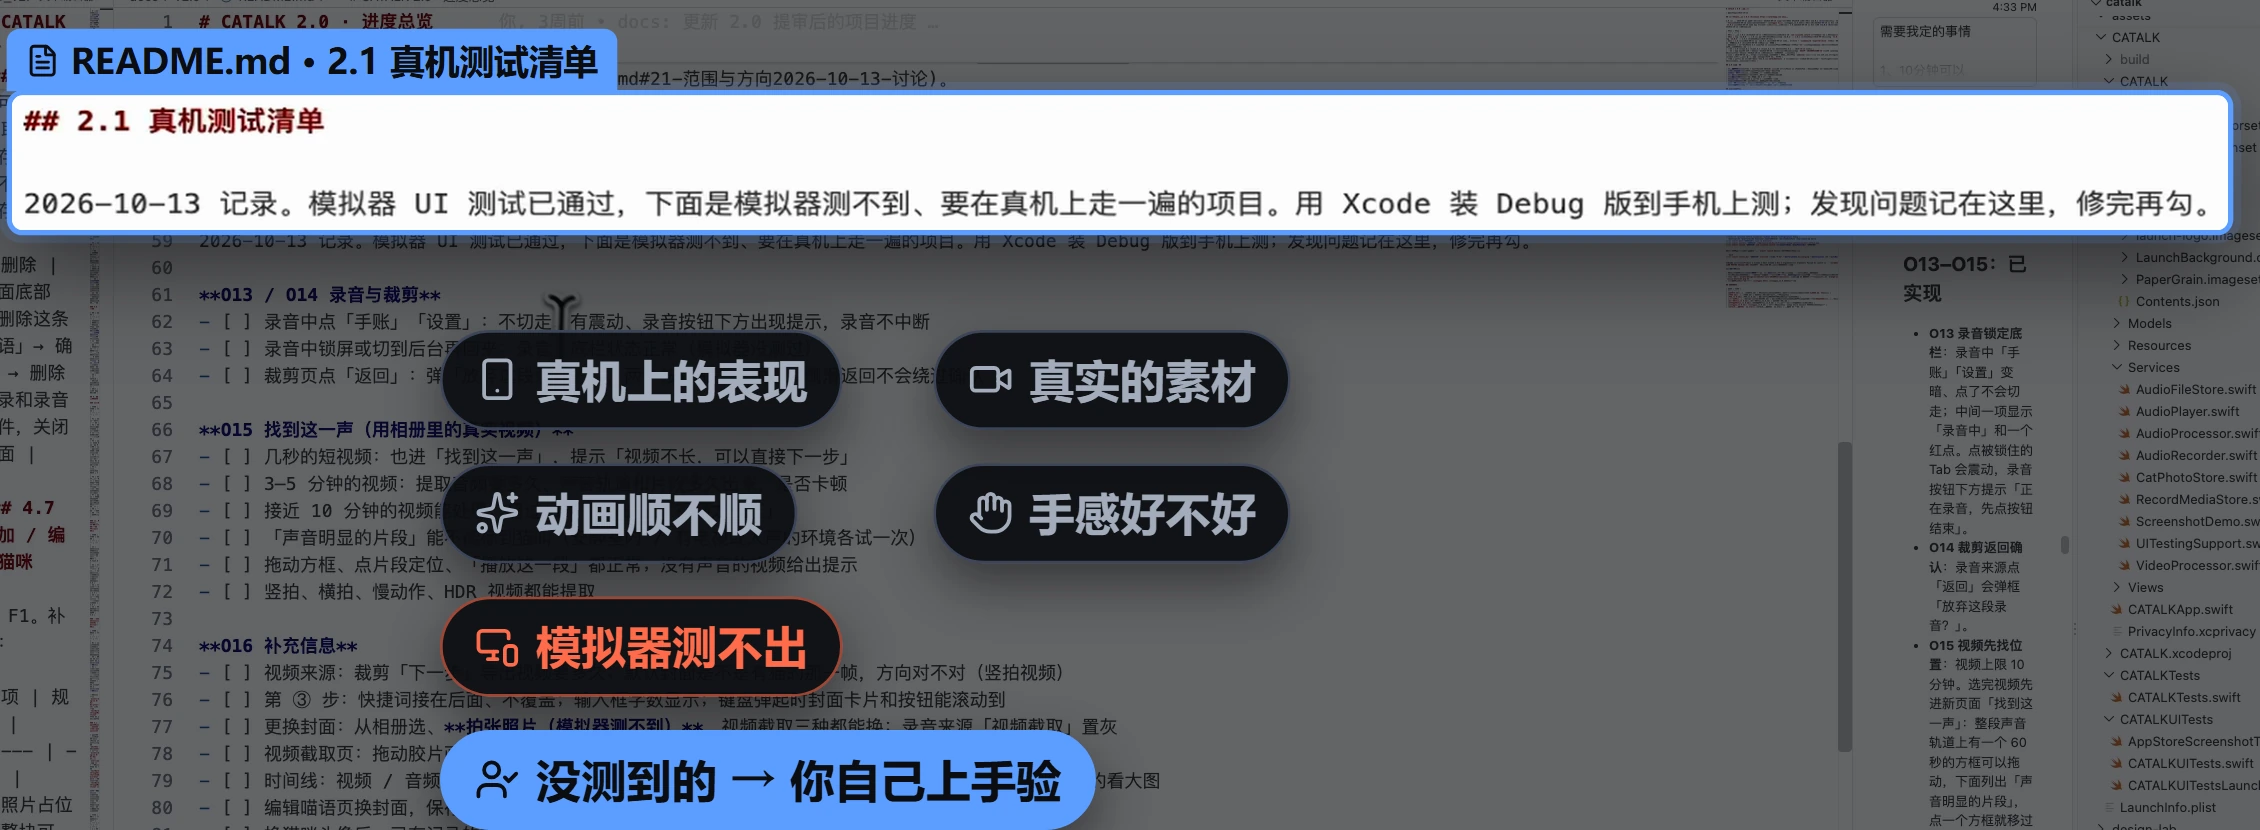
自动化测试也不是万能的。真机上的表现、真实的素材、动画顺不顺、手感好不好,这些模拟器测不出来。让 AI 跑完顺便告诉你哪些没测到,你自己上手体验一下就可以。
一段提示词,让 AI 当你的测试工程师
把上面三步合起来,就是下面这段提示词,可以直接发给你做项目的 AI:
你现在是这个项目的测试工程师。请帮我给这个项目建一套能自动运行的测试:

1. 先读一遍项目的需求文档和现有代码,列出一份测试用例清单:至少一条从头走到尾的主流程,再加上需求里的每条规则、返回和取消这类操作,以及空数据、数量很多这类边界情况;
2. 测试要能自动运行,具体用什么工具,你根据这个项目自己选;
3. 测试不要碰我的真实数据;测试里拿不到的东西,你自己造一份测试数据;
4. 写完自己跑一遍,告诉我哪些通过、哪些没通过,以及有哪些是自动测试测不到、需要我自己上手验证的;
5. 最后把运行测试的方法写进项目的说明文件,并加一条规则:以后每次改完代码都要跑一遍测试,结果写在回复里。

先不要写测试,先把测试用例清单列给我,我确认之后再开始。
注意,这段提示词不是教 AI 怎么写测试代码,而是告诉它:你现在是这个项目的测试工程师。用什么工具,它会根据你的项目自己选。
发出去以后,它会把需求文档和代码读一遍,列出一份测试用例清单给你看:主流程怎么走、每条规则怎么查、哪些边界要测。你看过清单觉得没问题,回一句「可以开始测试」,它就会把测试写出来、自己跑一遍,再告诉你哪些通过了、哪些没通过、哪些需要你自己上手验。
会不会很耗 token?
不会太多。测试脚本只需要 AI 写一次;以后每次跑,都是脚本自己去点、自己检查,这部分不消耗 token。AI 只需要看一眼结果,判断哪里出了问题。
总结:活交给 AI,你决定测什么、什么时候测
以后产品每一次迭代,改完代码,AI 就会自动把这套流程跑一遍。改了这里、坏了那里,第一时间就能发现,不用再自己每个页面挨个点。
以前测试工程师干的活,现在可以交给 AI。你要做的,是让它知道该测什么、什么时候测:
- 先列清单:主流程、每条规则、返回 / 取消 / 放弃、边界情况,你确认后再写;
- 造假数据:测试里拿不到的东西,让 AI 自己造一份;
- 写进入口文件:每次改完代码都跑测试,结果写在回复里;
- 测不到的你来验:真机表现、动画、手感,让 AI 列出来,你上手体验。
如果你做的是网页,思路完全一样:AI 可以用 Playwright 这类工具打开浏览器自己去点。工具不一样,方法是一样的。
一个人做产品,你不用每个岗位都会,但每个岗位的活都得有人干,现在这个人可以是 AI。想让 AI 分岗位协作,可以接着看 给 AI 搭一个产研团队。
Vibe Coding 做产品,怎么让 AI 做全流程测试?+
分三步:先让 AI 读需求文档列测试用例清单,你确认后再写;测试里拿不到的东西(相册、相机、网络)让 AI 造假数据;把运行测试的方法和「每次改完都要跑测试」的规则写进 CLAUDE.md 或 AGENTS.md 这类入口文件。
测试用例清单至少要包含什么?+
至少一条从头走到尾的主流程,需求里每一条规则对应一个检查,返回、取消、放弃这类操作,以及一条数据都没有、数据特别多这类边界情况。
自动化测试会不会很耗 token?+
不会太多。测试脚本由 AI 写一次,以后每次运行都是脚本自己点、自己检查,不消耗 token,AI 只需要看结果判断哪里出了问题。
自动化测试能代替自己上手试用吗?+
不能。真机上的表现、真实素材、动画顺不顺、手感好不好,模拟器测不出来。可以让 AI 跑完后列出哪些没测到,再自己上手验证。